DeepSeek 的昇腾赌局:先改“写算子”的方式,再谈摆脱 CUDA
目录
DeepSeek 的昇腾赌局:先改“写算子”的方式,再谈摆脱 CUDA
- DeepSeek 把 TileLang 等算子工具链推到华为昇腾 950,DeepGEMM、DeepEP、FlashMLA、TileKernels、DeepSelect 同步推出昇腾版本。变化发生在“怎么写算子”,不只是一次硬件适配。
- 短期落点更偏推理:据彭博社报道,16 万颗昇腾 950DT 订单主要面向推理侧,训练环节目前仍主要依赖英伟达。
- TileLang 用前后端解耦和多级分块,把通用矩阵乘法从 500 多行 CUDA 压到 30 多行 Python;性能数据来自来源文章,仍需结合具体场景看。
- 真要把训练迁到昇腾,代码重写、NCCL 换 HCCL、华为产能与 Q4 交付,一个都绕不开。
先看结论:这是一次“开发方式”的迁移,不是一夜换芯
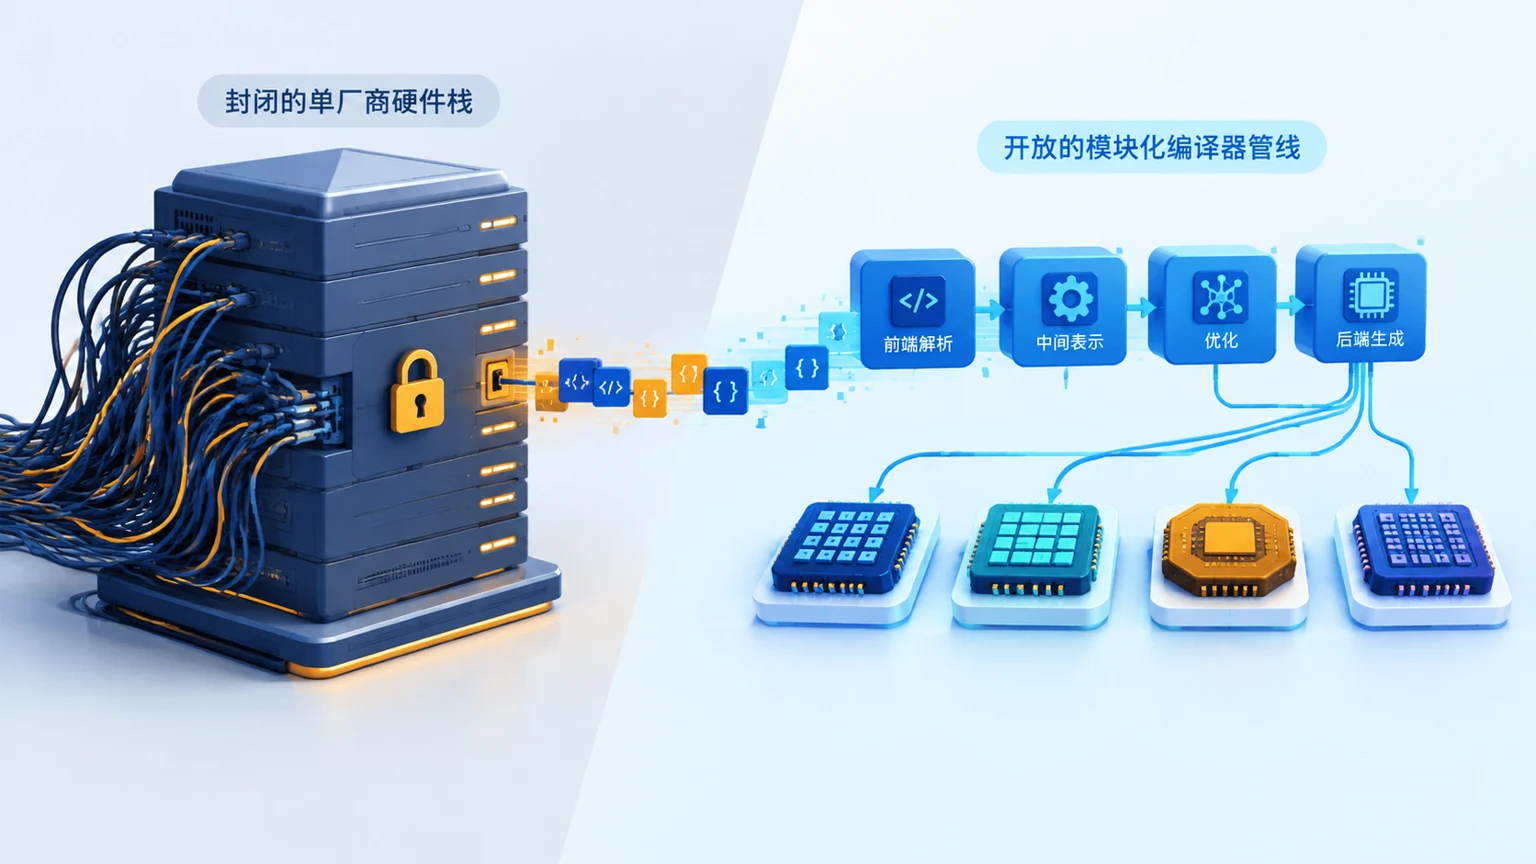
DeepSeek 这次做的事,用来源文章的话说,是“把给英伟达 GPU 写代码的全套工具链,原样铺到了华为昇腾 950 NPU 上”。TileLang 官宣原生支持昇腾,DeepGEMM、DeepEP、FlashMLA、TileKernels、DeepSelect 五个核心计算与通信库也同步出了昇腾版本。
如果只看“支持昇腾”四个字,容易把它理解成一次普通适配。更准确的理解是:过去大模型公司写核心算子,默认围绕 CUDA 展开;现在这套开发工具开始把“后端”当成可替换的部分。来源文章认为,这意味着国产算力第一次在核心算子工具层面,做到了与英伟达生态的能力对标。这是文章的判断,不是已经完成的事实。
另一个需要先分清的事实是节奏。昇腾 950DT 主要面向推理侧,训练环节目前仍主要依赖英伟达。所以“摆脱 CUDA”不是即时状态,而是一个先把开发方式搬过去、再逐步迁移训练负载的长期过程。
算子为什么卡脖子:芯片算力再高,也要有人把活派明白
“写算子”一直是大模型底层开发里门槛最高、耗时最久的工作之一。来源简报给了一个很具体的对比:一张芯片的理论算力上限很高,但如果底层算子写不达标,计算单元会大量时间等数据流转,几万块钱的芯片可能只能发挥 20% 的性能。写算子的目标,是把硬件利用率从 20% 推到 95% 以上。
这件事难在细节。以矩阵乘法为例,开发者要手动管理芯片内部的三级存储,调度线程块,安排数据预取流水线,有时还要深入寄存器分块和指令重排。模型算法迭代又很快,芯片厂商的官方算子库很难跟上新算子的出现速度。
旧有路径大致有三条,各有各的卡点。手写 CUDA 的性能天花板最高,但开发效率极低,而且深度绑定英伟达生态,无法跨平台移植。厂商预制算子库,比如英伟达 cuBLAS 的标准算子,开箱即用、性能拉满,但灵活性差,开发者改不了内部逻辑,也做不了算子融合,新算法容易卡在算力层。高层 DSL 编译器如 OpenAI 的 Triton 降低了门槛,但性能上限受编译器优化策略限制,对昇腾、AMD 等非英伟达硬件的原生支持度低,异构适配成本高。
来源文章称 TileLang 开辟了第四条路,试图同时兼顾开发灵活性、运行性能和跨平台能力。这个说法能否成立,要看它的架构和实际跑分。
TileLang 的关键不是多一个库,而是把编译器和硬件拆开
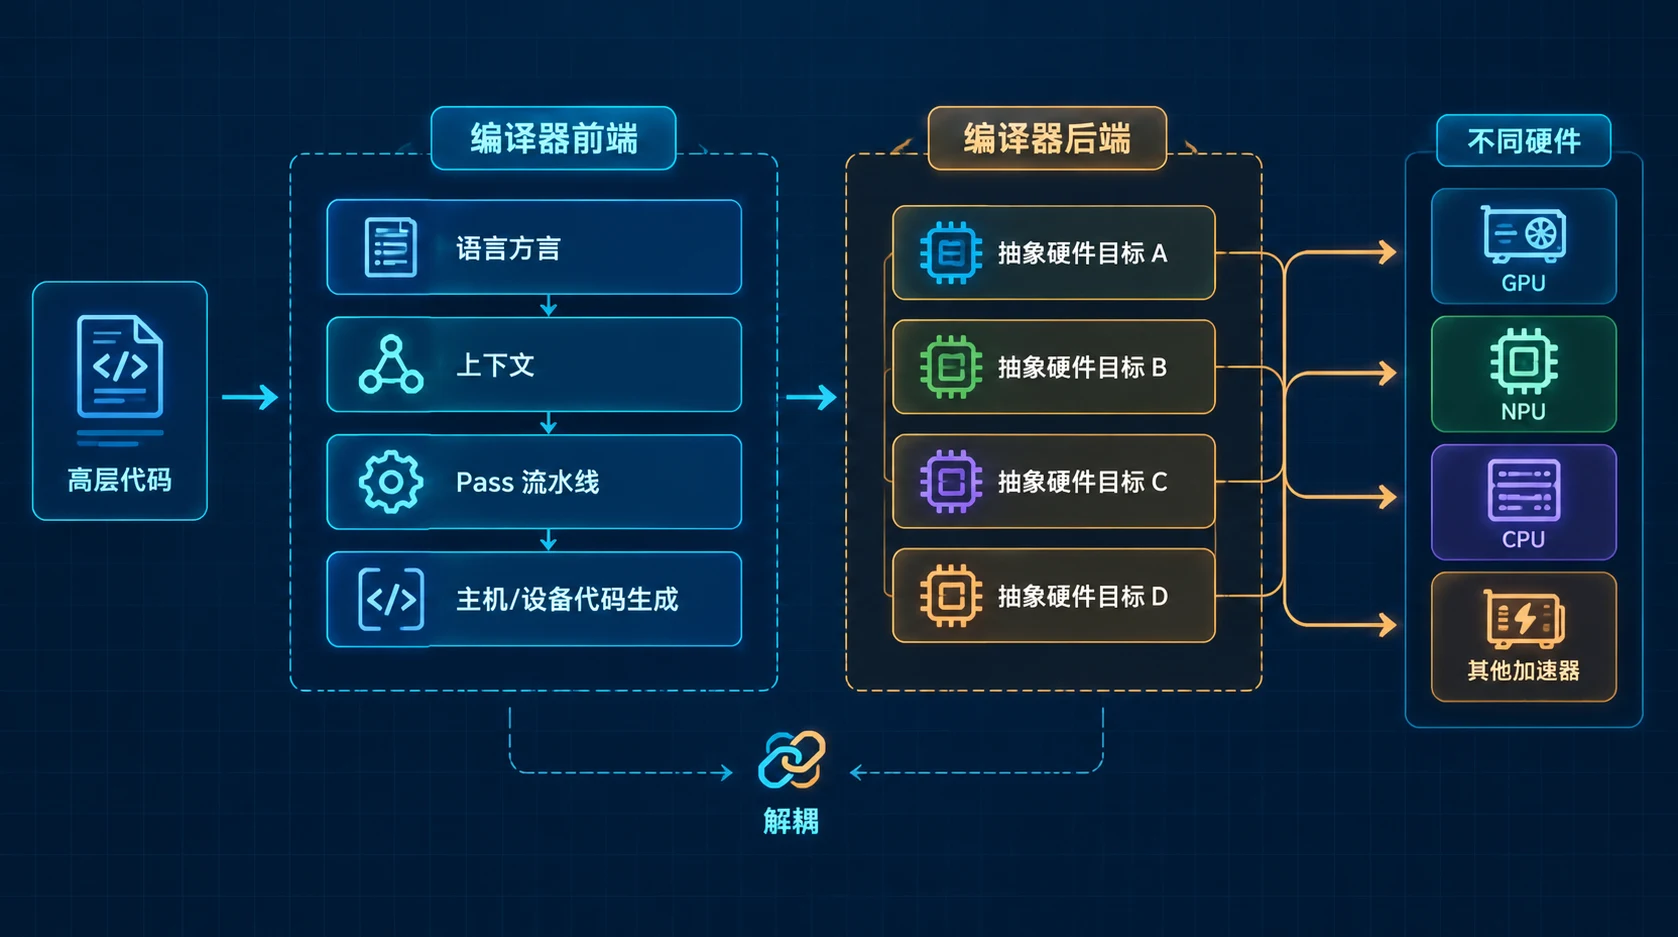
TileLang 的架构核心是“前后端解耦,目标与执行分离”。目标后端只负责定义硬件指令语法和优化规则;执行后端负责通用编译、加载、启动流程。新芯片要接入,主要是新增一个目标后端,而不是把整套工具重写一遍。
每个目标后端遵循统一的四层流水线:语言方言、上下文贡献、Pass 流水线、主机/设备代码生成。语言方言层把代码翻译成芯片能听懂的指令,比如 CUDA 后端注入 WGMMA 和 TCGEN05 等张量核心指令,昇腾后端翻译为 Ascend C 的底层向量指令与矩阵运算原语;上下文贡献层感知当前芯片,把不同硬件规格参数统一成标准格式;Pass 流水线负责把高层逻辑转换成芯片能跑的底层代码,并针对不同芯片做优化;最后一层把代码拆成主机侧和设备侧两份,主机侧跑在 CPU 上负责任务调度,设备侧跑在 AI 加速器上承担核心计算。
对开发者更直接的是多级分块。TileLang 把庞大计算任务切成标准化数据块,开发者只需声明“每块数据在哪里计算”,编译器自动完成数据搬运、线程同步等底层工作。开发者仍然可以在三个维度上做显式控制:存储控制决定数据放在全局内存、共享内存还是寄存器;线程调度可以用一句代码把矩阵计算划分给芯片里的计算核心;并行节奏可以用 T.Pipelined(num_stages=3) 开启三级软件流水线,让数据搬运和算力计算异步并行。
这些设计带来的一个可验证结果是代码量。来源简报称,用上述三个维度编写的通用矩阵乘法算子,可以把传统 CUDA 实现通常需要 500 行以上的代码压缩到 30 多行 Python 代码。TileLang 主攻的通用矩阵乘法、反量化 GEMM、FlashAttention、线性注意力、稀疏 MLA 等算子,据文章说法承载大模型训练和推理 90% 以上的计算量。
性能方面,来源文章给出的数据是:在英伟达 H100 上运行核心算子,TileLang 速度大幅超越 PyTorch 原生实现,击败 Triton,并追平英伟达官方调校的 cuBLAS 以及官方版 FlashAttention;在 AMD MI300X 上拿到接近硬件极限的跑分;基于 TileLang 优化的 DeepSeek V3.2 稀疏注意力 TopK 算子,比原生 PyTorch 快 2–20 倍。这些数字来自来源文章,适合作为判断依据之一,但不能替代具体业务场景下的实测。
TileLang 也不是凭空出现的项目。它最早由北京大学团队在 Apache TVM 编译器基础设施上孵化,TVM 由华盛顿大学陈天奇团队开发,现为 Apache 顶级项目。DeepSeek 把它推到生产环境,再反向捐赠给开源社区。据来源简报,截至 2026 年 9 月,TileLang 仓库收获 7.6k stars、1,992 次 commit。目前它以英伟达 CUDA 为核心主力,AMD ROCm、苹果 Metal、华为昇腾 950 为官方支持级,LLVM CPU、WebGPU、CuTe DSL 等处于实验阶段,沐曦、摩尔线程、海光等国产芯片通过生态项目适配。
DeepSeek 把筹码压到昇腾:推理先走,训练还在英伟达
工具链发布不是孤立动作,它和 DeepSeek 的算力采购绑在一起。
9 月 21 日,据《The Information》报道,梁文锋在投资人闭门会上把“使用华为或其他国产芯片训练模型”描述为公司当前“最大的赌注之一”,并明确表示此役“必须成功”。据彭博社此前报道,DeepSeek 已投入 25.6 亿美元的订单,采购至少 16 万颗华为昇腾 950DT 加速器,用于部署在内蒙古乌兰察布在建的吉瓦级数据中心,这笔订单最快 2026 年 Q4 开始交付。这批昇腾 950DT 主要面向推理侧,训练环节目前仍主要依赖英伟达。
模型规模也在推高算力需求。来源简报称,DeepSeek 正在训练一款 2 万亿参数的大模型,参数规模超过现有旗舰 V4 的 1.6 万亿;梁文锋同时透露,公司已规划 8 万亿参数的更大模型。按梁文锋此前估算,训练一款与 OpenAI 同级别的大模型,大约需要 5 万颗英伟达 GB300 处理器,对应需要 20 万颗华为昇腾 950 芯片。16 万颗的订单规模,放在这个换算里就能看出它还不是“完全替代”的量级。
供给端也有明确约束。知情人士透露,受先进内存等核心元器件短缺影响,华为正面临生产瓶颈,DeepSeek 短期内仍无法完全摆脱对英伟达硬件的依赖。这让“赌注”更接近一场有时间表的工程推进,而不是一次性切换。
从业者真正的难关:代码、通信、产能,一个都不能少
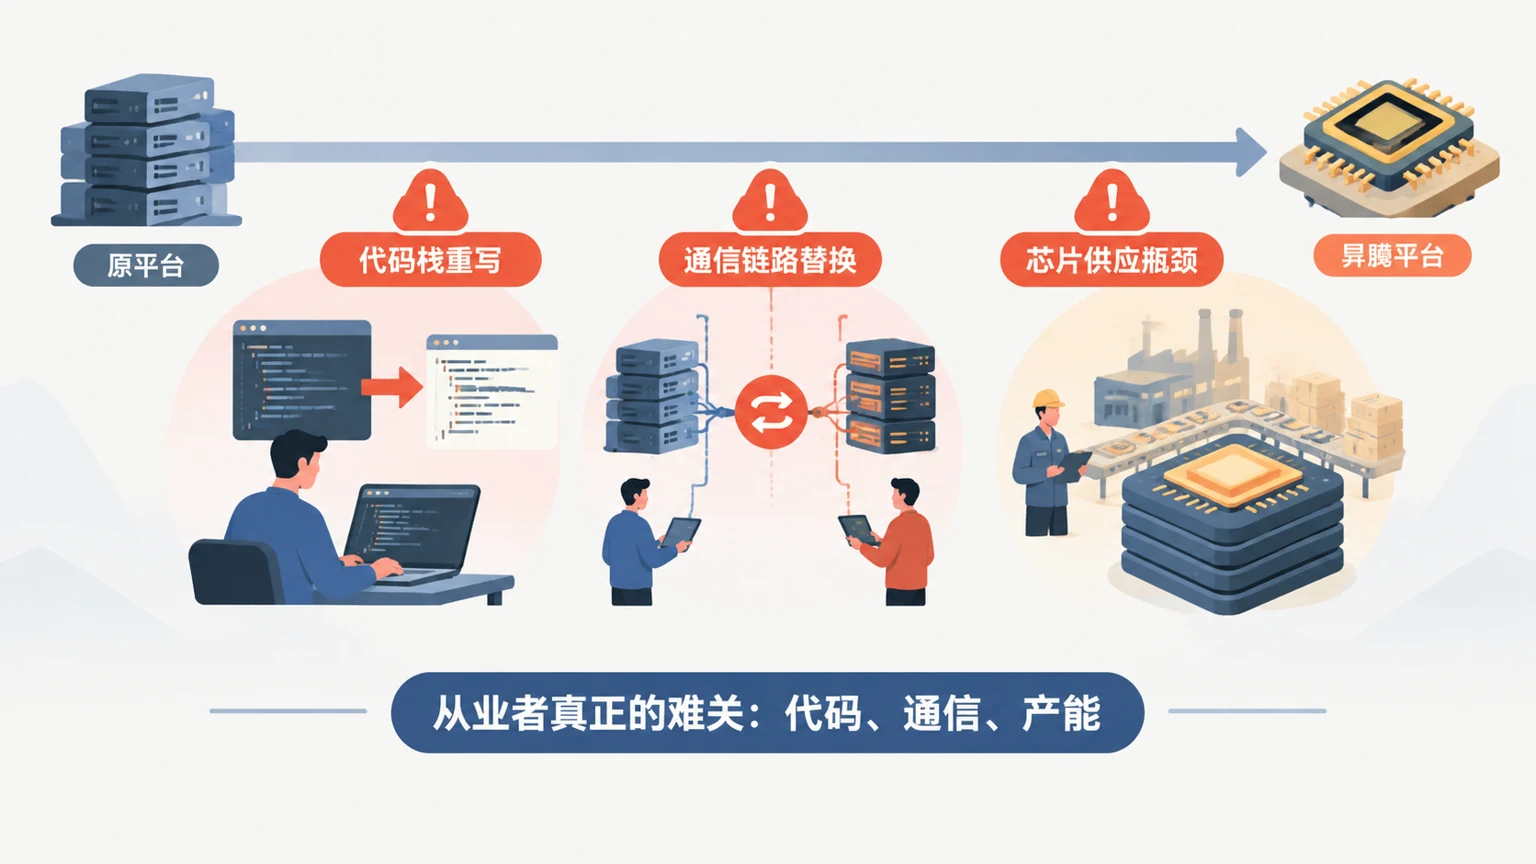
对做训练系统的人来说,“TileLang 原生支持昇腾”不等于“代码拿过去就能跑”。来源简报把迁移难点拆成三个:训练软件栈全部重写、通信原语底层替换、芯片产能押注。
第一关是代码。DeepSeek-V3、V4 的训练代码最早是为英伟达 Tensor Core / Hopper 架构的 WGMMA 指令写的。要在昇腾上跑,必须把每一处 cuBLAS/NCCL 调用替换成 Ascend C/HCCL,并逐一在昇腾 950 上验证 FlashMLA、DeepEP、DeepGEMM 等自研核心算子的性能。这不是改几个接口名,而是要把核心计算路径重新走通。
第二关是通信。大模型训练要在成千上万颗加速器之间同步梯度,通信原语是并行训练的基石。NCCL 与 HCCL 在 API 设计、性能曲线、容错模型上完全不同。来源文章有一句判断很具体:“从 NCCL 到 HCCL 的迁移不是改个 import 那么简单。”任何一个集合通信操作的适配偏差,都可能导致整轮训练静默失效。对训练团队来说,这类问题最难排查,因为表面看训练还在跑,结果可能已经不可用。
第三关是产能。美国出口管制推动 DeepSeek 转向国产芯片,但同一管制政策也制约华为扩大 Ascend 950 产能的能力。DeepSeek 押注 16 万颗昇腾的隐含前提,是华为 Q4 交付不能掉链子。来源文章把这句话说得很直白:“华为的 Q4 交付不能掉链子。”
未来 12 个月,看四个硬指标
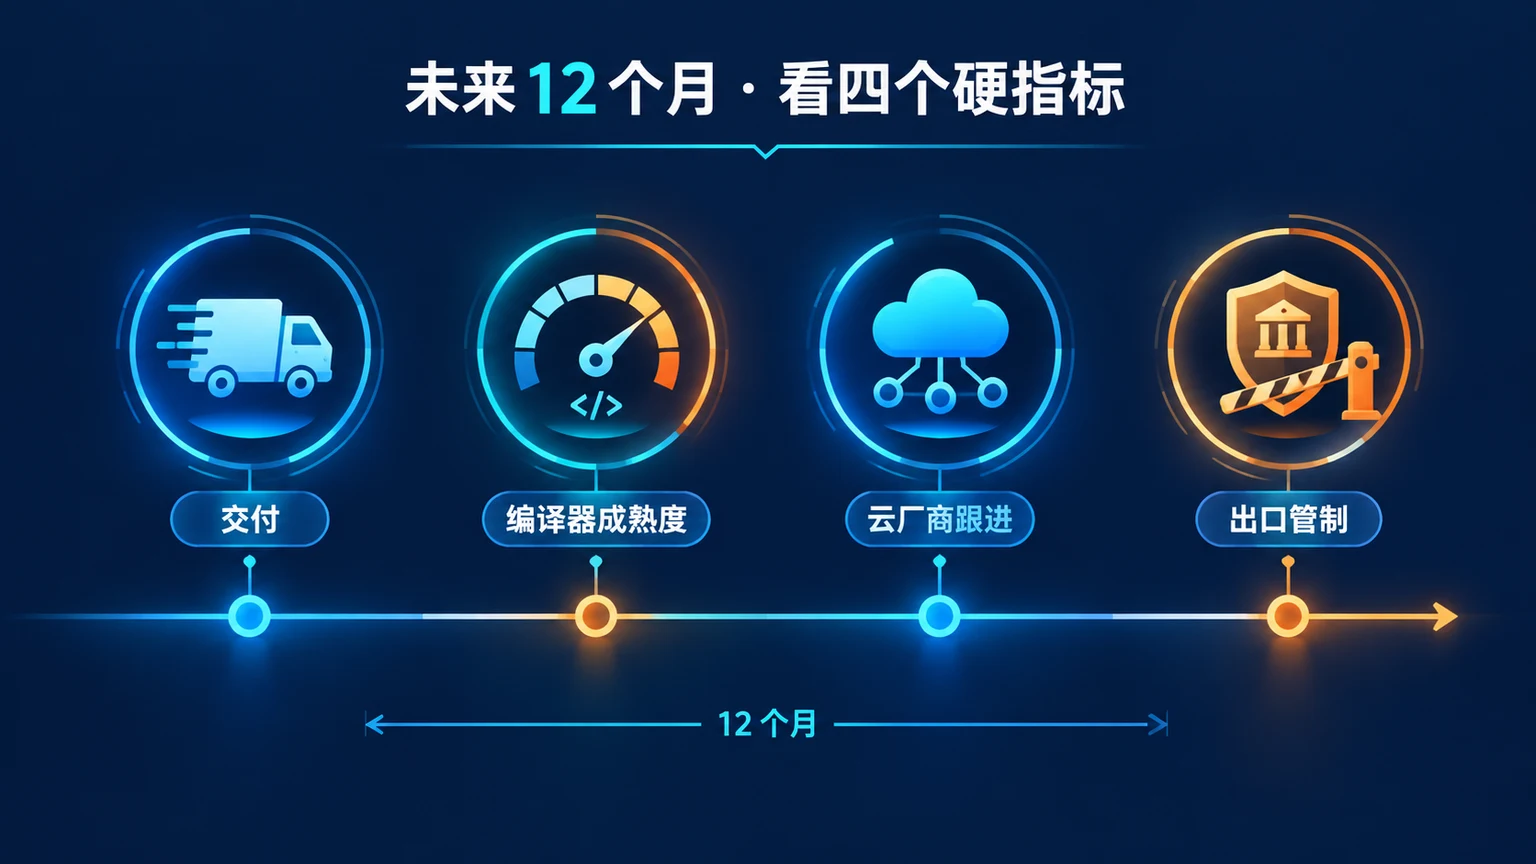
这场赌局目前没有定论。来源文章给出的观察框架是四个变量:
一是华为 Ascend 950 的 Q4 交付率。订单签了,能不能按时按量交到数据中心,决定推理侧迁移的进度。
二是 TileLang 昇腾后端能否在 6 个月内追平 CUDA 后端。原生支持是起点,工具链成熟度要看编译器优化、算子覆盖和实际性能。
三是字节、腾讯、阿里是否跟随押注昇腾。如果只有 DeepSeek 一家走这条路,生态适配的成本会主要由它承担;如果更多大模型厂商基于 TileLang 开发算子,来源文章认为国产芯片的适配成本会指数级下降,整个生态的迭代速度也会加快。这是文章的判断,能否发生取决于后续动作。
四是美国出口管制是否再次升级。它既影响 DeepSeek 能买到什么,也影响华为能扩多少产能。
TileLang 的开源,把“国产算力生态怎么建”从一个工程问题变成了一个生态问题。但生态问题不会因为一次发布就解决。未来一年,上面四个指标会比任何口号都更能说明这场赌局走到了哪一步。
来源:查看原文