机器人AI不必全背在身上:推理卸载能换来什么,又要付出什么
目录
机器人AI不必全背在身上:推理卸载能换来什么,又要付出什么
- 微软研究院的文章提出一个反直觉的假设:物理 AI 的推理不必全部跑在机器人身上的 GPU 上,可以分一部分到边缘或云 GPU。
- 在代表性的移动操作任务中,卸载推理提升了任务成功率、让更大的模型跑得起来,也改善了续航;代价则是网络延迟、带宽和可用 GPU 资源。
- 板载 GPU 的代价有具体数字:建图与规划相比 A100 最多慢 383%,导航及时检测障碍物的能力下降 30%,VLA 模型准确率下降 50%;Jetson Thor 这类大 GPU 会让 Stretch-3 的电池消耗最多增加 160%(以上数字均来自来源简报)。
- 配套的 Physical AI Toolchain 新增了基于 Kubernetes 的分布式推理编排能力,并给出 SO-101、UR10e 等示例;文中“首个”的说法属于来源表述,尚无独立第三方验证。
一个厨房任务,暴露了“身上那块 GPU”的天花板
微软研究院用一个很日常的场景说明问题:机器人进厨房,检查有没有垃圾,有的话把它放进垃圾桶。
这个动作听起来简单,背后的移动操作栈却不轻——语义建图与规划、导航、操作,再加上视觉-语言-动作(VLA)模型。文章指出,目前的主流做法是在机器人身上配一块 GPU,比如把 GPU 直接连接到机器人上。
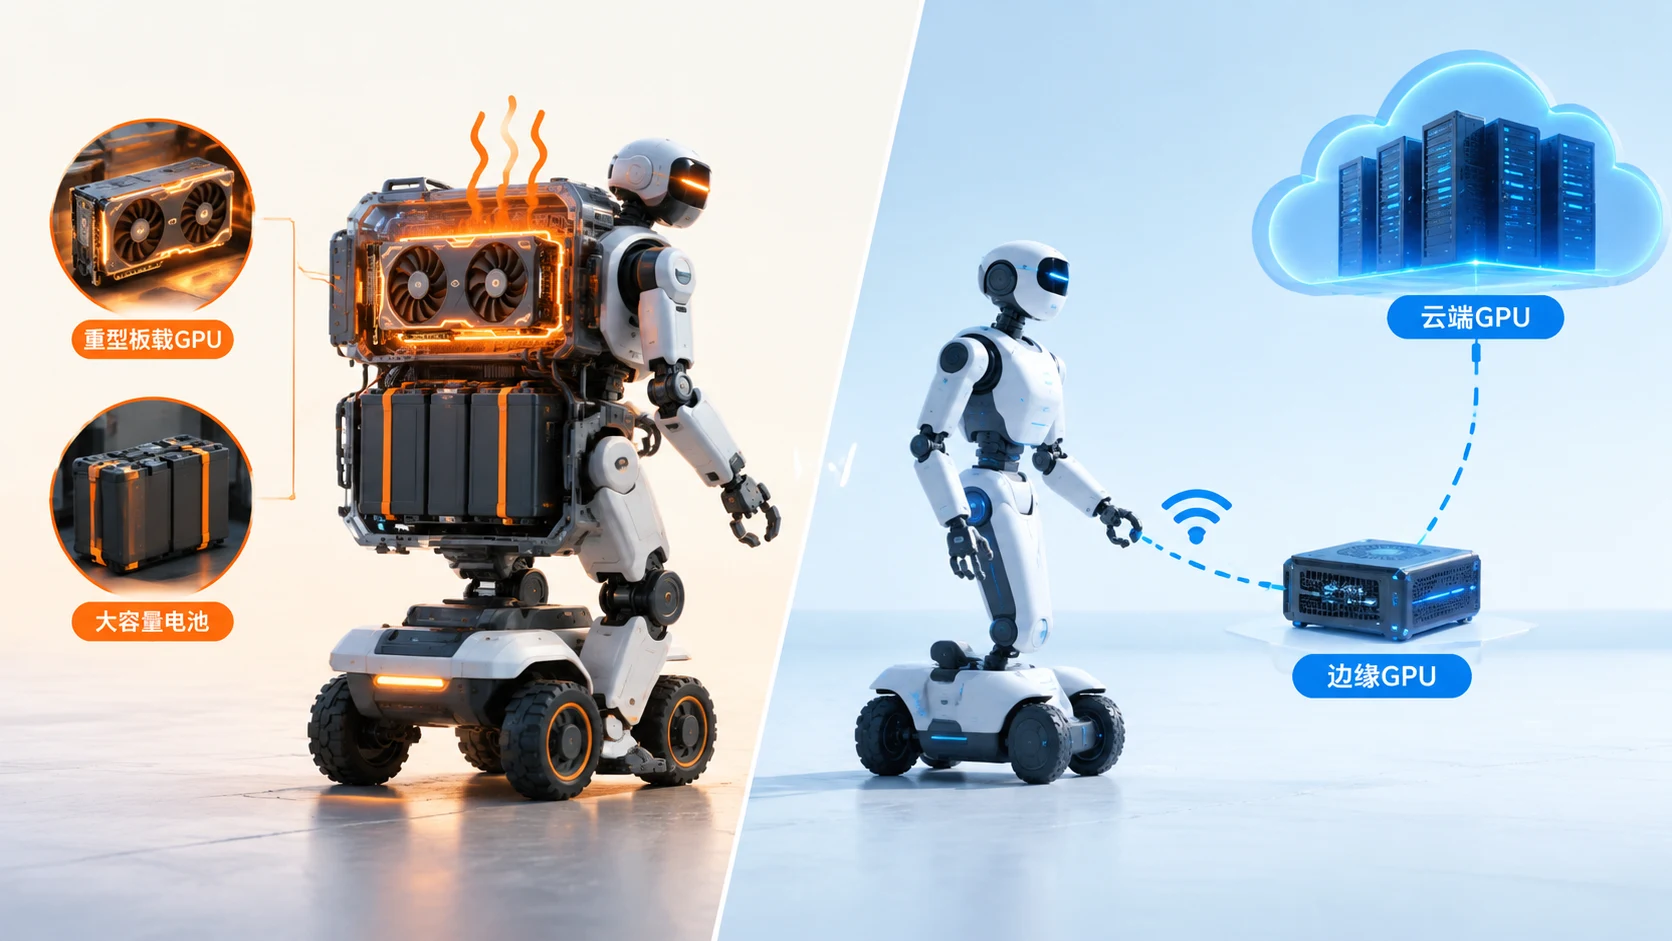
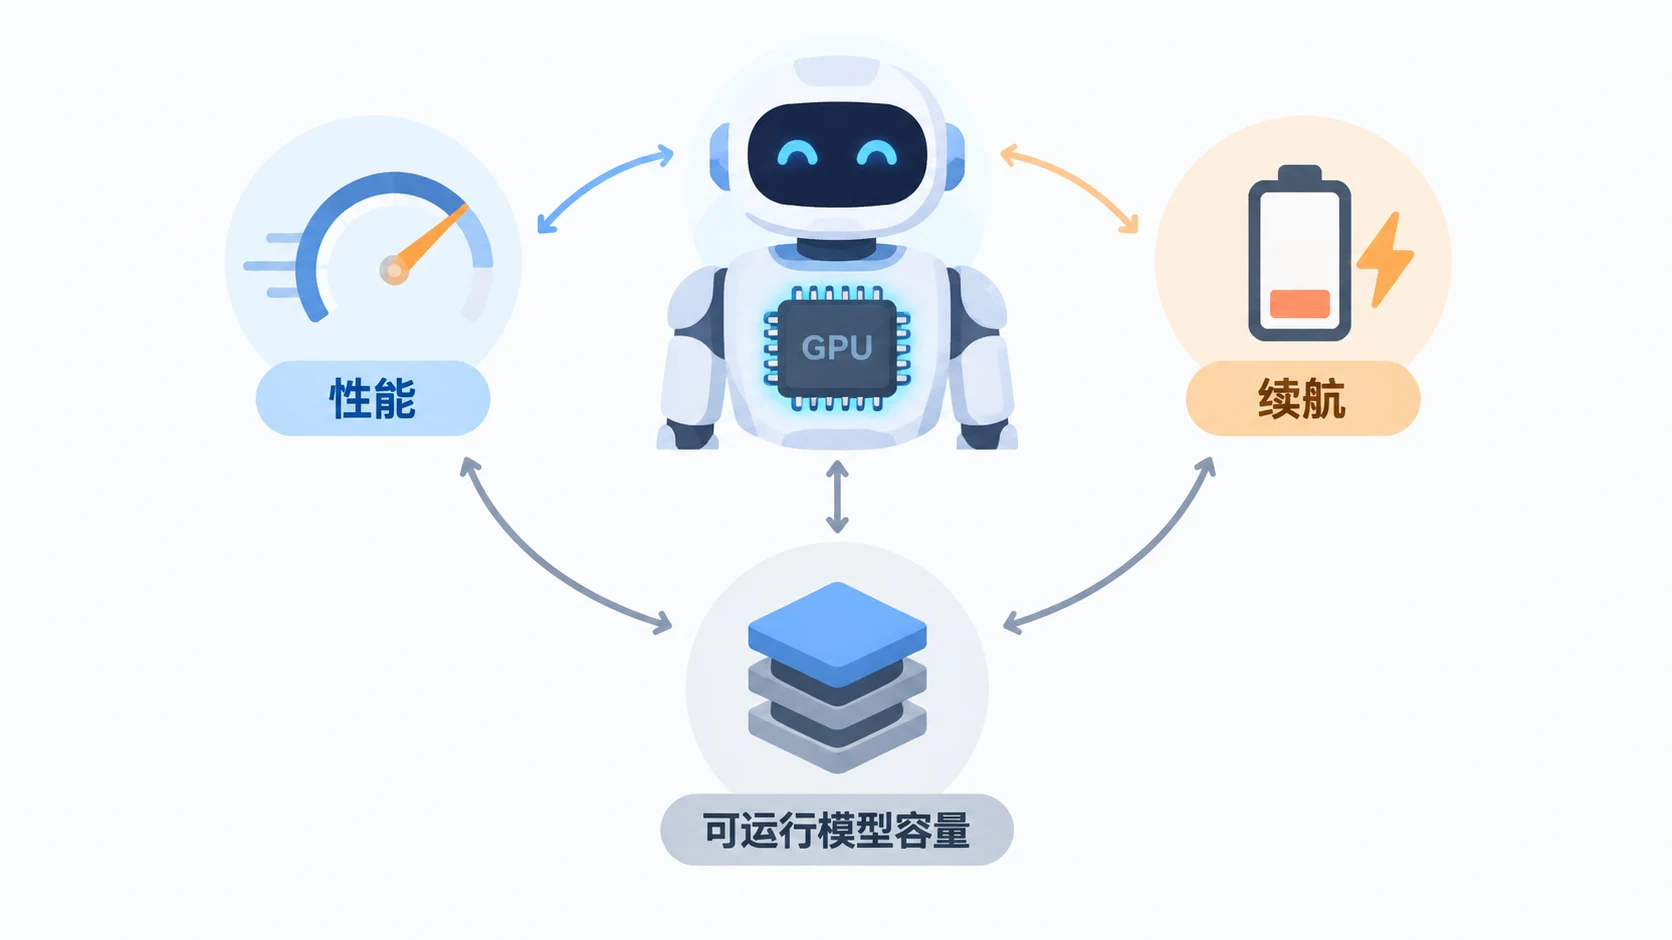
问题就出在这里。文章称,仅在板载 GPU 上运行物理 AI 推理,会限制机器人的性能、电池寿命和可扩展性。更直接的一条是:一些较小的 GPU 根本装不下整个移动操作栈。
换句话说,机器人不是不想聪明,是身上的算力预算不够。
板载 GPU 的三笔账:变慢、耗电、装不下大模型
文章用三组数字把“不够”量化了。这些数字来自其对多种板载、边缘和云计算配置的评估,具体测试硬件细节在技术报告中。
第一笔是速度。在内存足够的 GPU 上,建图与规划相比 A100 最多变慢 383%。建图与规划一旦变慢,机器人在动态空间里的反应能力就被压缩。
第二笔是安全相关的检测能力。导航在使用较轻 GPU 时,及时检测障碍物的能力下降 30%。
第三笔是模型精度。VLA 模型在较小 GPU 上并没有显著变慢,但这个幅度的变慢已足以让准确率下降 50%。
除了算力,还有物理账。文章写道,GPU 功耗高、降低电池寿命、增加成本与重量,并可能限制运行最新一代 AI 模型。以较大的板载 GPU 为例,Jetson Thor 可使机器人电池消耗增加最多 160%,或者减少数小时续航;图 5 的这组数据针对的是 Stretch-3 机器人。
卸载之后:收益是真的,但延迟和带宽会来收账
文章称,把推理卸载到边缘或云 GPU 可以带来显著优势。在代表性移动操作工作负载中,卸载推理提升了任务成功率,使更大的 AI 模型可以运行,并帮助机器人在动态真实环境中更有效地响应。
续航的改善有具体实验支撑:研究者用一块 Raspberry Pi-5 板替换板载 GPU,把所有数据发送到卸载 GPU,以此比较两种方案的电池表现。文章的结论是,用轻量板载硬件加远程推理替代高功耗的板载 AI 计算,可显著改善电池寿命,让机器人两次充电之间跑得更久。
但这不是免费午餐。文章明确把卸载推理描述为性能、网络延迟与带宽、可用 GPU 资源之间的复杂权衡。机器人一旦依赖网络,链路质量就成了系统的一部分;远程 GPU 也不是无限的,调度和争用都会影响结果。
Kubernetes 把推理拆开:机器人、边缘和云各管一段
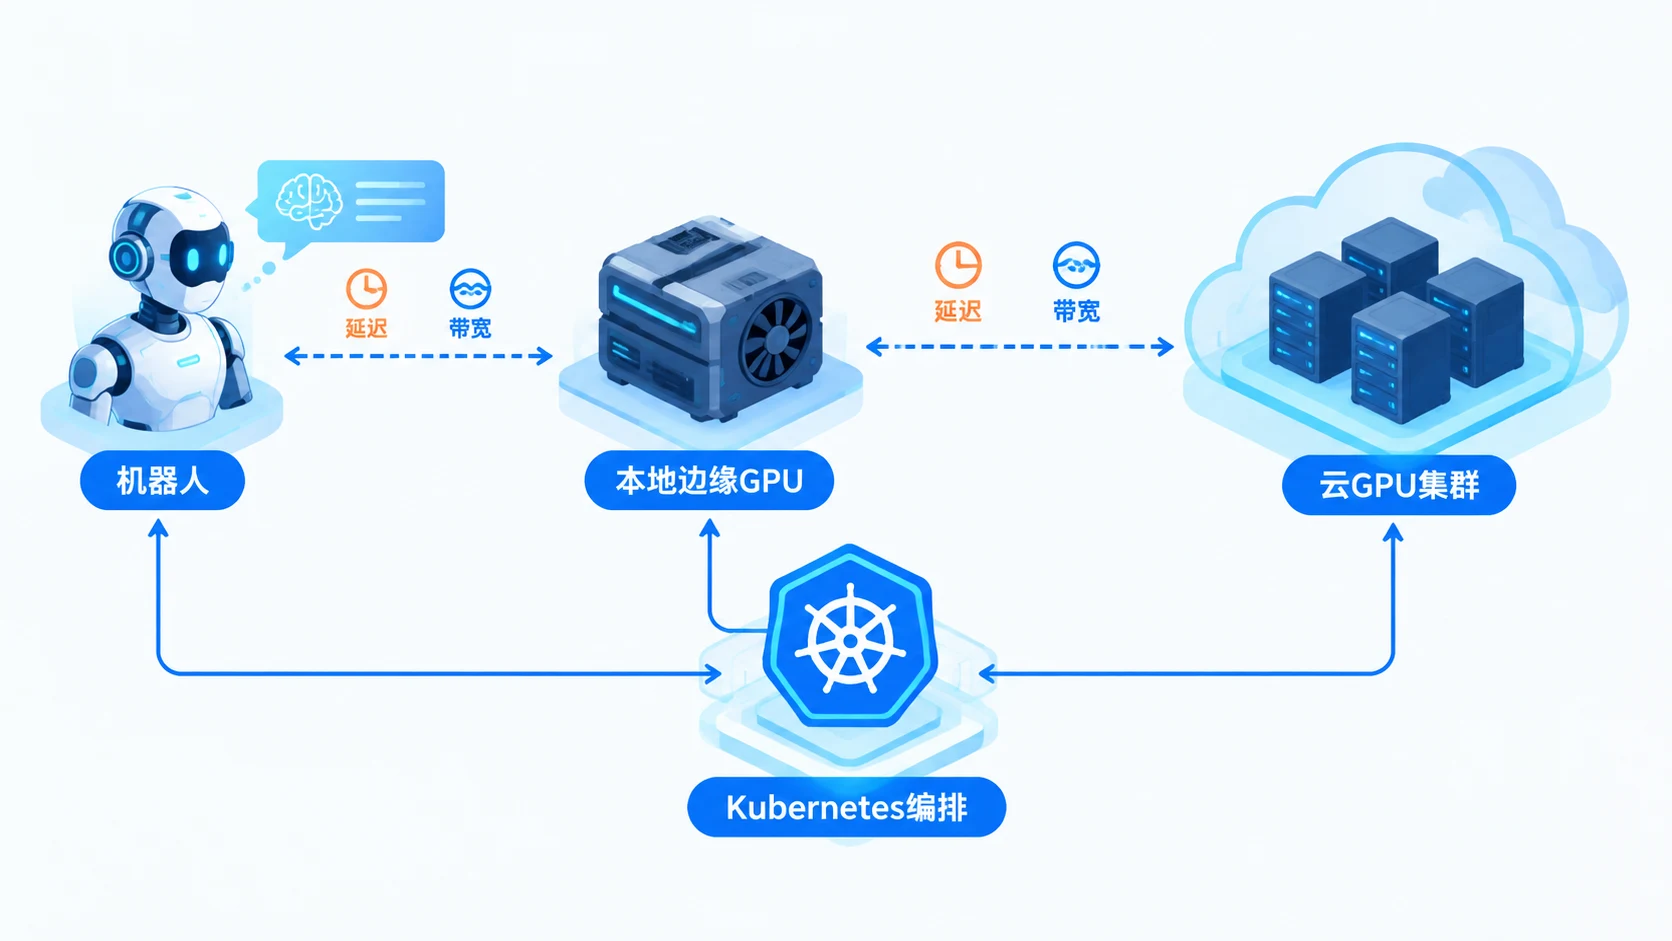
工具链的技术路径,是用统一编排把机器人 AI 工作负载分布到不同位置。
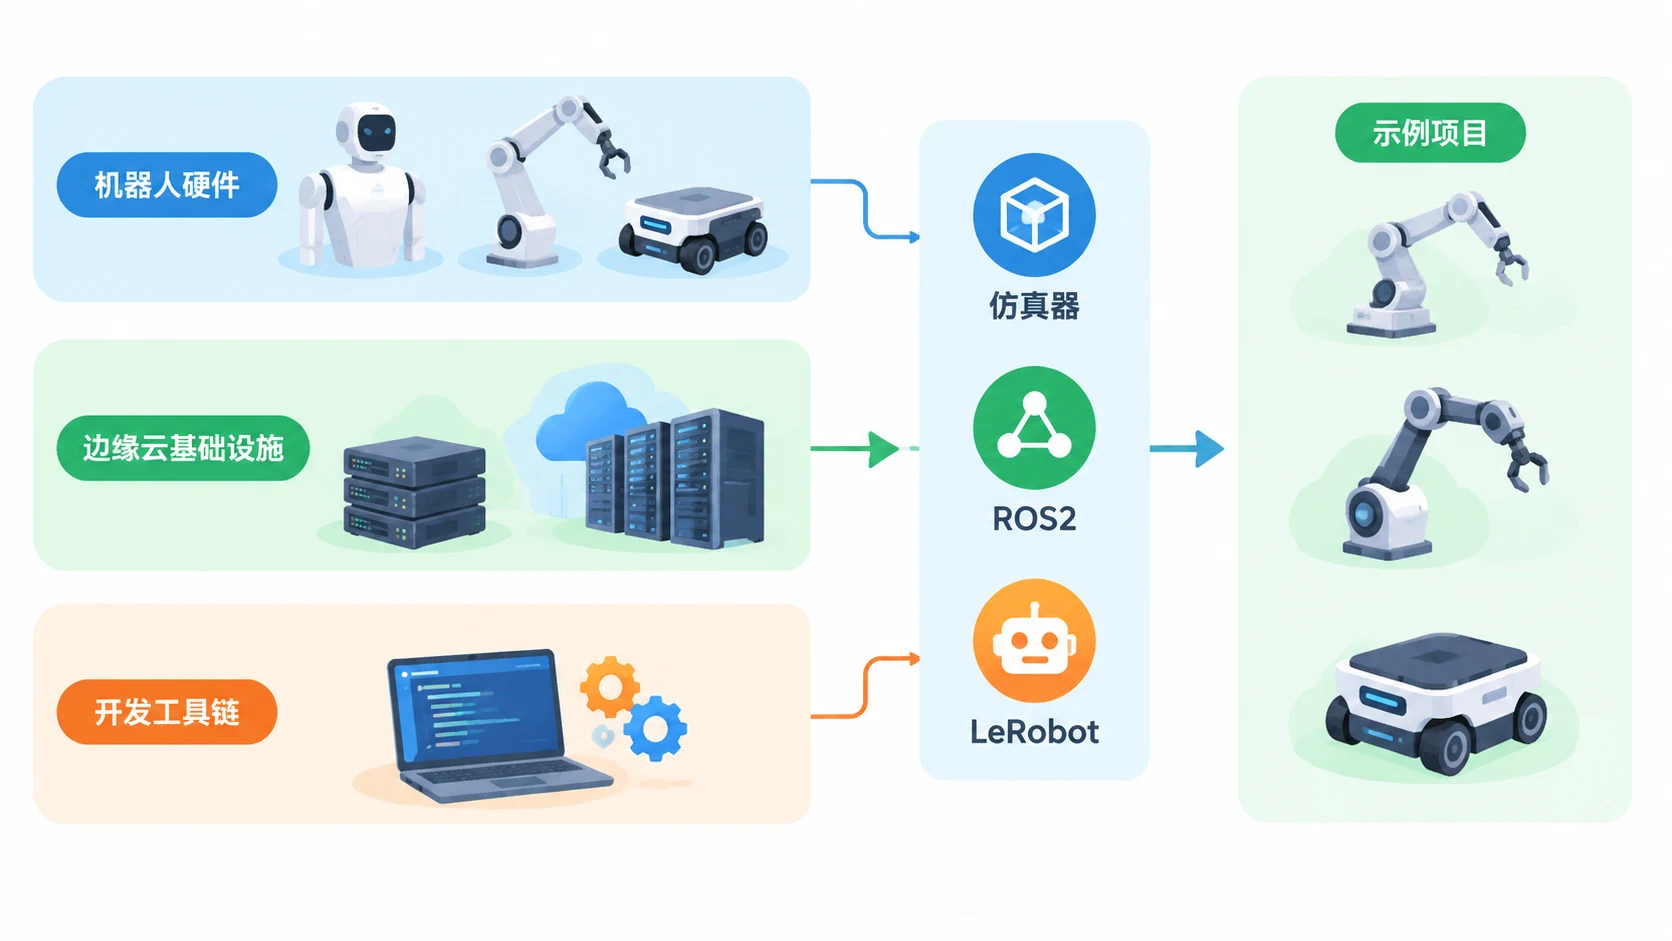
按文章描述,开发者可以用基于 Kubernetes 的工具,在机器人、边缘基础设施和云之间容器化、部署和编排机器人 AI 工作负载,实现分布式推理。工具支持基于声明式规范的自动容器化与卸载,并用 Kubernetes 的智能策略分发物理 AI 容器。它同时集成了机器人模拟器、LeRobot 和 ROS2。
一个容易被忽略的分工细节是:高层规划可能在云中执行,但任务执行通常仍绑定在机器人自身。据此可以推断,这套方案更接近“按任务分层放置推理”,而不是把所有计算一股脑搬到云上——这个判断是我的推断,不是文章原话。
对开发者意味着什么:开源工具链和几个能上手的示例
微软已发布 Physical AI Toolchain,文章将其描述为开源、生产就绪的框架,集成 Microsoft Azure 云服务与 NVIDIA 物理 AI 栈。它的目标是加速机器人与物理 AI 开发者在感知、移动、模仿学习和强化学习流水线中的数据策展、增强与评估自动化及规模化。
这次发布包含 SO-101 和 UR10e 的推理卸载示例项目。另有一段视频展示:把面向双臂机器人的 Microsoft Rho 模型推理卸载到 Jetson Thor GPU,并控制 Mobile Aloha 机器人。文章还称,该能力已在许多真实用例中测试过。
对从业者来说,实际影响在于编排门槛:过去要自己拼网络、容器和调度,现在有一部分被收进了声明式规范和 Kubernetes 策略里。
谁该关注,边界在哪:别把演示当成通用结论
文章把物理 AI 的落点放在制造、家庭和仓库等场景,认为它能提升安全性、生产力和辅助能力。文章同时提出,实现这个愿景需要三个维度同时进步:机器人硬件、具身 AI 模型、训练与推理系统基础设施。这篇文章聚焦的是其中最不常被讨论的一块——推理基础设施。
判断是否值得采用卸载推理,可以先过三个问题:任务能否拆分,哪些推理必须留在本地;现场网络延迟和带宽是否撑得住远程调用;边缘或云端的 GPU 资源是否稳定可用。文章本身就把这三项列为权衡因素。
还需要分清证据的边界。研究结果基于代表性的移动操作工作负载,不等同于所有机器人场景;电池影响的“最多 160% 或数小时”也有具体测量条件,需要查技术报告;“首个系统性研究”和“行业首个”属于文章表述,未提供独立第三方验证。
对普通读者,这件事的意义可以归结为一句:机器人变聪明不一定靠往身上堆更重的硬件,但把算力搬出去,网络和资源调度的账迟早要算。