Agent 越聊越贵,问题不在上下文太长:拆解 TokenPilot 的双层缓存策略
目录
Agent 越聊越贵,问题不在上下文太长:拆解 TokenPilot 的双层缓存策略
要点
- 长会话 Agent 的成本压力来自上下文不断累积;常见做法是剪枝或淘汰记忆,但这会打乱序列布局,带来前缀错位与缓存失效。
- TokenPilot 把上下文管理拆成两层:入口处的全局压缩稳定前缀,会话中的局部淘汰按保守批次卸载过期内容。
- 论文报告的降本数字是隔离模式 61%、56%,连续模式 61%、87%,测试平台为 PinchBench 与 Claw-Eval;性能表述是「与既有系统相当」,不是超越。
- 摘要没给实现细节、超参和失败案例,HTML 版本标注为实验性,这些是判断可信度时该留的余地。
Agent 的账单,是被「历史」撑起来的
一篇 2026 年 6 月的论文把这件事说得很直白:随着 LLM Agent 被部署到长周期会话中,上下文累积会推高推理成本(原文表述为 context accumulation drives up inference costs)。论文标题是 TokenPilot: Cache-Efficient Context Management for LLM Agents,作者包括 Buqiang Xu、Zirui Xue、Dianmou Chen 等十五人。
这里的关键词是「长周期」。一次问答不会让成本失控,真正撑起账单的是会话不断变长——每一步推理都要把之前的历史一并送进模型。历史越长,每轮都要重复付出这部分开销。Agent 与普通聊天机器人的差别在于,它会连续执行多轮任务,中间产生工具调用、中间结果、环境反馈,这些都会沉淀进上下文。
本节要说明的是:成本问题的起点不是模型单价,而是「历史」这一项的持续累积。
删上下文,为什么反而可能更贵
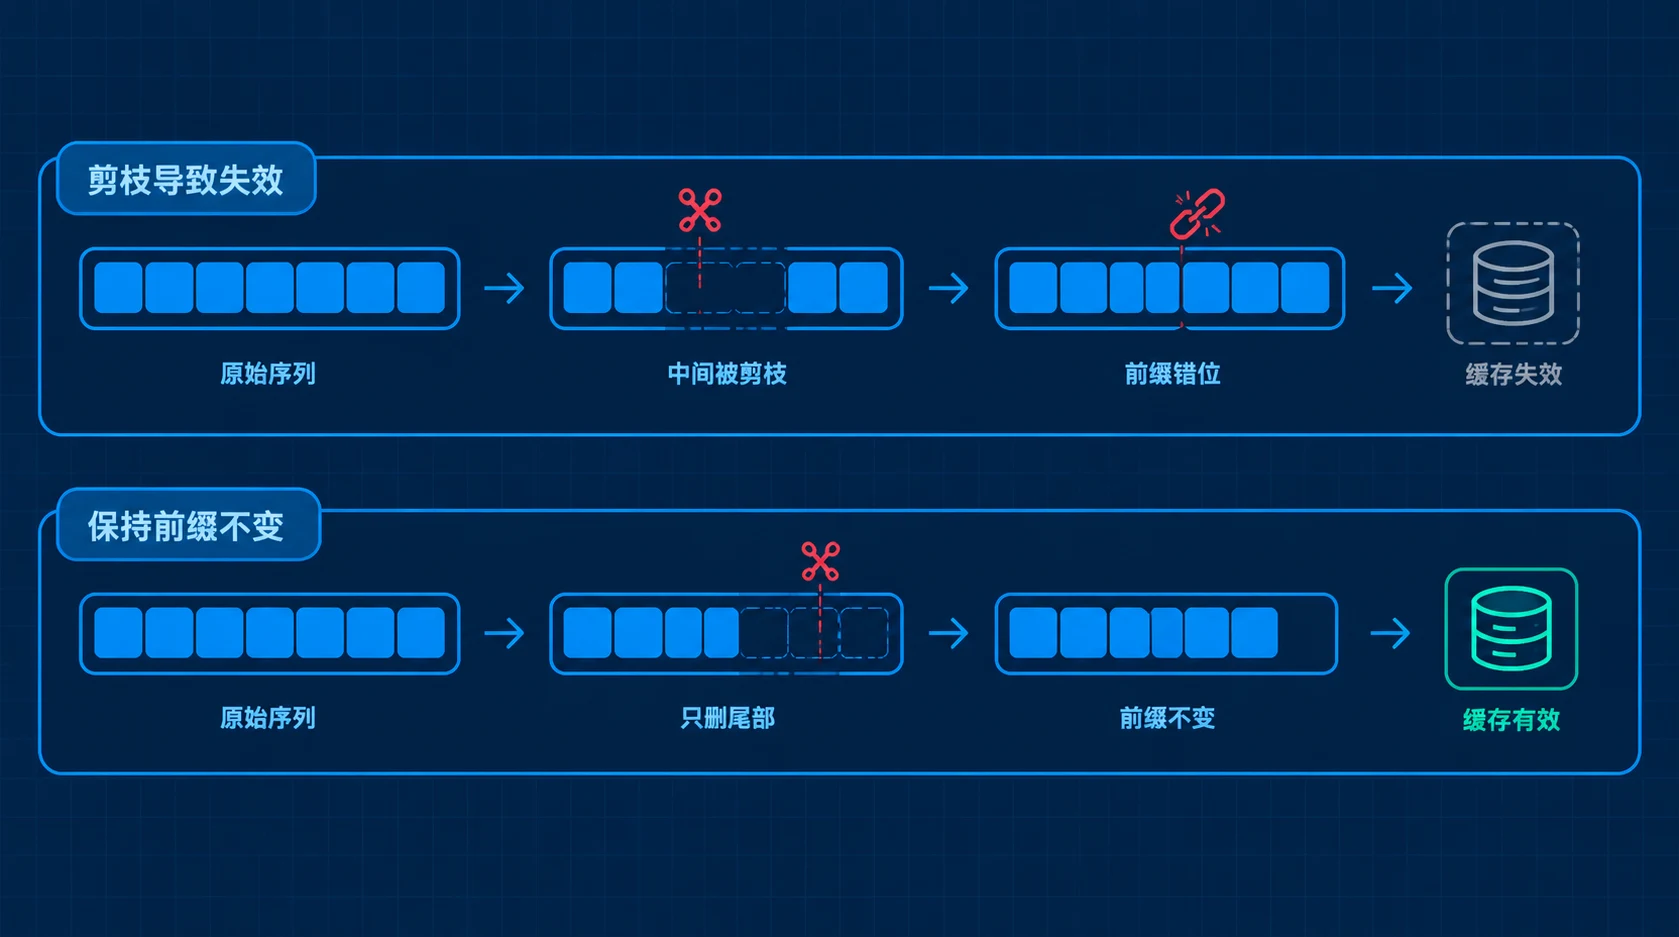
直觉上的解法是删。论文指出,既有方案正是通过文本剪枝(text pruning)或动态记忆淘汰(dynamic memory eviction)来压缩 token 占用。问题出在下一步:这些方法对序列的改动是不受约束的,会改变整体布局(unconstrained sequence mutations alter layouts)。
布局一变,代价就来了。论文明确列出两个后果:前缀错位(prefix mismatches)和缓存失效(cache invalidation)。论文把这件事概括为「文本稀疏性与 prompt 缓存连续性之间的关键权衡」(a critical trade-off between text sparsity and prompt cache continuity)。
换句话说,省下来的 token 和丢掉的缓存命中,是两笔账。前者容易看见,后者藏在推理基础设施里。从中间删掉一段历史,后面的内容整体前移,前缀就不再与缓存中记录的版本对齐,原本可以复用的部分需要重新计算。删得越随意,命中率越差。
本节要说明的是:剪枝减少的是输入长度,却可能同时破坏缓存复用,两者方向相反。
两个闸门:入口压缩与生命周期淘汰
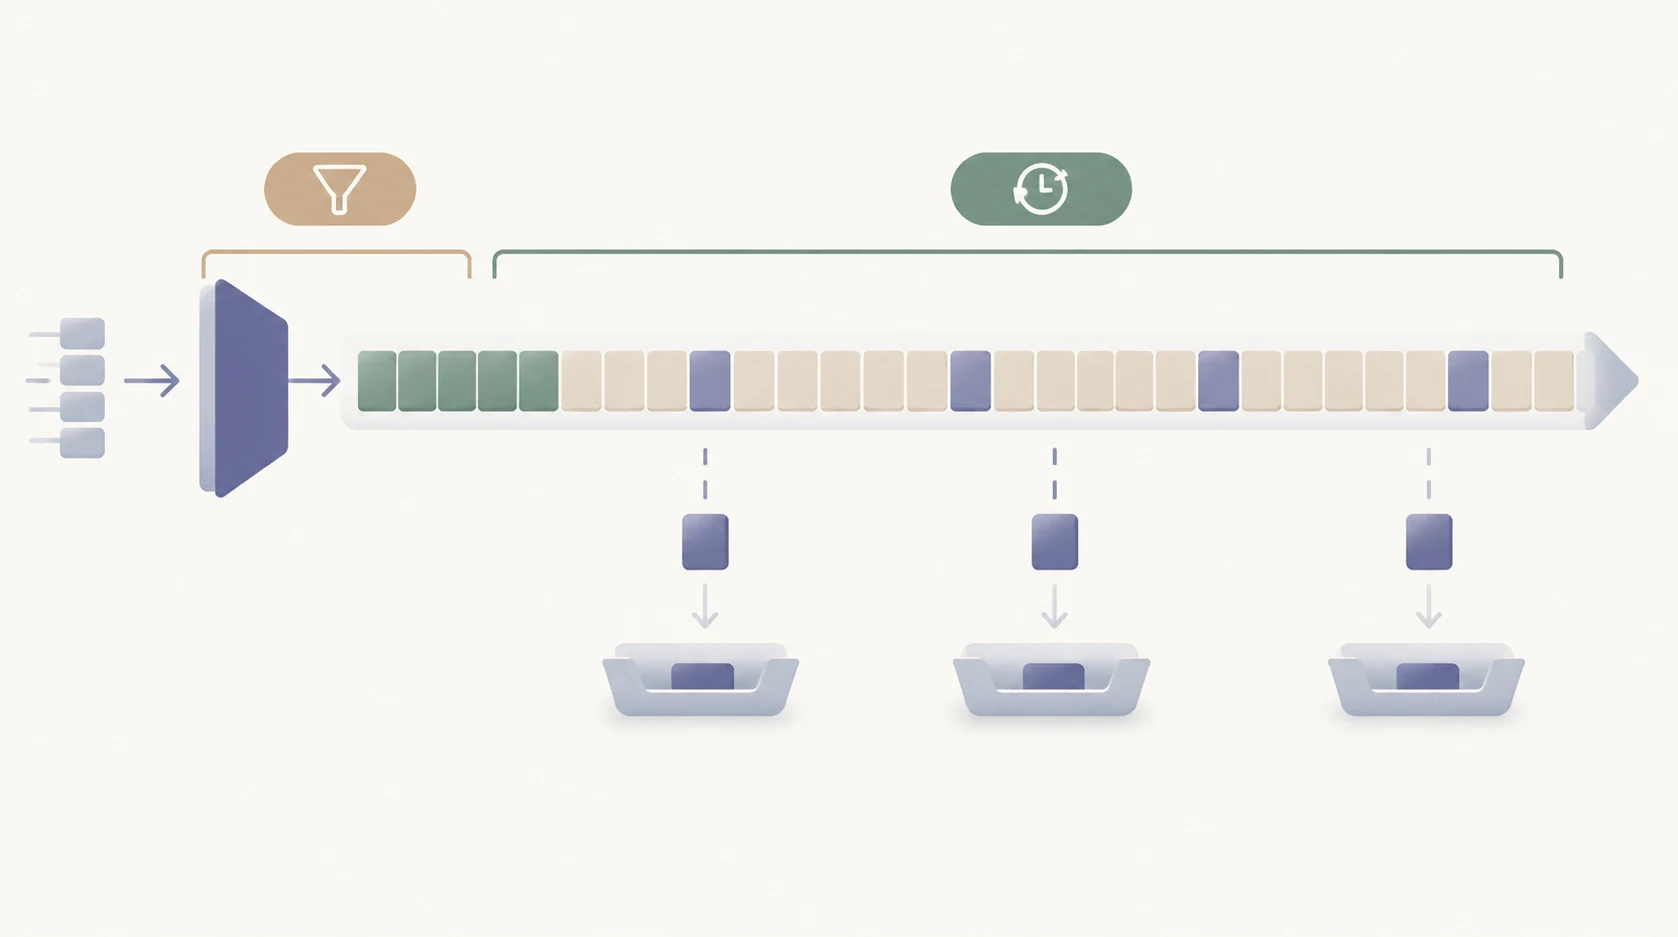
TokenPilot 的应对方式是分层,论文称之为「双层粒度的上下文管理框架」(a dual-granularity context management framework)。两层各管一件事。
全局层是 Ingestion-Aware Compaction,位置在入口。它的职责被描述为充当框架级挂载(framework harness),在摄入闸门处稳定 prompt 前缀,并清除开放环境带来的噪声。注意它处理的是「进来的东西」,目标是让前缀保持稳定。
局部层是 Lifecycle-Aware Eviction,位置在会话进行中。它持续监控上下文片段的残余效用(ongoing residual utility of context segments),执行的是保守的批次轮次调度(conservative batch-turn schedule),只在任务相关性过期时才把内容片段卸载出去。
两层的分工可以这样理解:入口层管「怎么写进来」,尽量保证前缀可预测;局部层管「什么时候拿走」,并且把拿走这件事限制在保守的节奏里,而不是每轮都动。这样的设计直接对准了上一节的问题——前缀错位和缓存失效,源头都是不受约束的序列改动。
本节要说明的是:这套机制的取舍点在于牺牲部分压缩自由度,换取前缀的连续性。
61%、56%、87%:这组数字该怎么读
论文给出的成本降幅是:在 PinchBench 和 Claw-Eval 上,隔离模式(isolated mode)下降 61% 与 56%,连续模式(continuous mode)下降 61% 与 87%。实验同时覆盖了隔离与连续两种模式。
几个必须一起读的限定条件:
- 摘要没有说明这几个百分比与两个基准之间的具体对应关系,哪一栏是哪个平台,本文不做推测。
- 摘要除成本降幅外,没有提供更细的基准指标。
- 性能方面的表述是「与既有系统相比具有竞争力」(maintaining competitive performance compared to prior systems)。这是「相当」,不是「超越」。
这三点合在一起,界定了这组数字能支撑的结论强度:它说明在特定平台和特定模式下成本有明显下降,且性能没有明显退步,但不构成「更好」的证据。
本节要说明的是:数字本身明确,但适用范围和结论强度由论文自己划定,读者应沿用这个边界。
从论文到产品:影响落在谁身上
论文提到 TokenPilot 已被集成进 LightRSI。在提供的文本中,LightRSI 的链接显示为「this https URL」,没有给出完整地址。
对从业者来说,这件事的落点可能在优化方向的调整上。以下属于推断:如果缓存连续性真的成为降本的硬约束,那么上下文管理的工作重点会从「压缩多少文本」转向「控制内容的写入与移除顺序」。这意味着评估一个方案时,除了看 token 节省比例,还要看它是否保持前缀稳定——后者往往决定了节省能不能兑现。
对普通读者来说,这类底层机制与产品体验是连着的。长会话 AI 产品的定价、可用会话长度、响应速度,都受推理成本约束。当成本结构发生变化,产品能提供的免费额度和会话时长也会跟着变。
论文的提交历史显示,v1 为 2026 年 6 月 15 日 17:46:50 UTC(1,641 KB),v2 为 2026 年 8 月 28 日 01:44:50 UTC(1,646 KB)。两个版本体积接近。
本节要说明的是:集成信息是事实,对行业影响的判断是推断,两者需要分开看。
还没回答的问题
有几项限制值得在阅读前记住:
- 评测只在 PinchBench 和 Claw-Eval 上进行,覆盖隔离与连续两种模式,没有其他平台的数据。
- 性能是「相当」,论文没有声称超过既有系统。
- 摘要没有提供实现细节、超参数,也没有失败案例。
- HTML 版本被标注为实验性(experimental)。
这四项决定了当前能验证到什么程度。一套上下文管理方案的实际表现,往往取决于实现细节和超参选择,而这些在摘要层面是看不到的。若要在生产环境采用,还需要回到完整论文和代码层面确认。
来源:查看原文