两周、零人工干预:AI 造出的 Redwood 芯片,真正改写的是设计周期
目录
两周、零人工干预:AI 造出的 Redwood 芯片,真正改写的是设计周期
先把读者能拿到的信息放在前面。以下事实与数字均来自来源简报所对应的论文 arXiv:2608.26418。
- 自动化覆盖到哪一步:Redwood 的输入是两位人类架构师给出的高层规格说明,规格之下没有人类干预;系统在不到两周内自主生成了性能模型、RTL 设计、UVM 验证环境、形式化证明、固件和内核,并完成部署。
- 验证强度与迭代速度:每个模块通过商用 EDA 工具、专有形式化引擎和硬件在环验证达到 95% 覆盖率;规格变更可在 48 小时内完成重新验证并重新部署到硬件。
- 性能数字的口径:1.75 倍吞吐、低 1.9 倍功耗、3.4 倍性能功耗比提升,是投影到三星 8nm 后的结果,对比对象是同一批模型上的实测 Jetson 基线,并非同工艺实测。
- 声明的边界:“首个由 AI 端到端设计并运行现代 AI 模型的生产级加速器”以“据作者所知”表述;论文为 arXiv 预印本,v1 于 2026 年 8 月 26 日提交,v2 于 8 月 28 日修订,未见同行评审说明。
值得关注的不是两周,而是流程被收进了一个闭环
把“两周做出一颗芯片”当成标题,容易读成一次速度炫技。但按论文自己的描述,Redwood 的意义在于它演示了一条完整链路:从软件到硅的整个栈被收敛进单一优化循环,硬件与软件在同一个目标下协同设计与验证。
换句话说,这件事的看点是交付物清单的长度和验证强度,而不是日历天数。性能模型、RTL、验证环境、形式化证明、固件、内核——这些通常由不同团队、不同工具链在不同阶段完成的工作,被同一个系统串起来,并且在规格说明之下没有人类介入。
论文提交历史显示提交人为 Sahand Salamat,编号 arXiv:2608.26418(cs 分类)。这是理解后续所有数字的前提:它是一篇预印本,不是经过同行评审的定论。
真正被卡住的不是算力,是两种时间尺度的错位
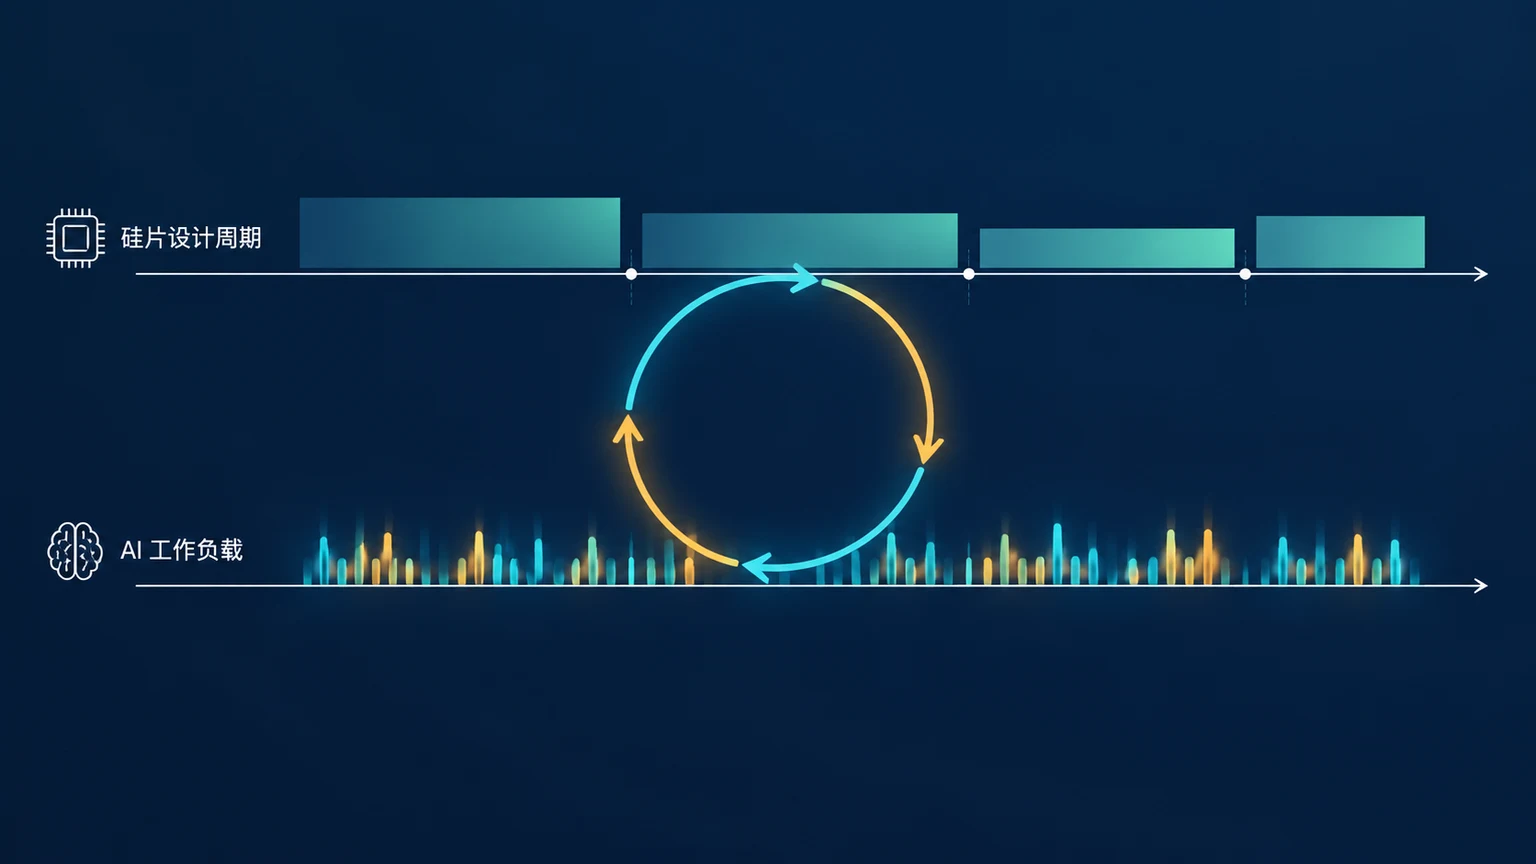
论文提出的问题并不新鲜,但描述得足够具体:架构定义比量产硅片早数年,而目标工作负载几个月就会变化。
这个错位带来双重代价。一是为对冲不确定性而增加的通用性——硬件不得不预留冗余以覆盖可能根本不会出现的负载;二是当新工作负载真的出现时,它很难映射到已经冻结的硅片上。论文的原话是“设计决策因此在深度不确定性下做出,并付出两次代价”(Design decisions are therefore committed under deep uncertainty and paid for twice)。
与此同时,摩尔定律停滞,论文认为专用化成为性能功耗比的主要剩余来源,而这要求“一种以工作负载节奏运行的设计周期”(a design cycle that runs at the cadence of the workloads)。
这里需要区分因果与主张:错位是行业长期存在的结构性问题,专用化是论文给出的应对方向,“设计周期跟上工作负载节奏”是它想验证的目标,不是已经普及的现实。
系统自主生成的到底是哪些交付物
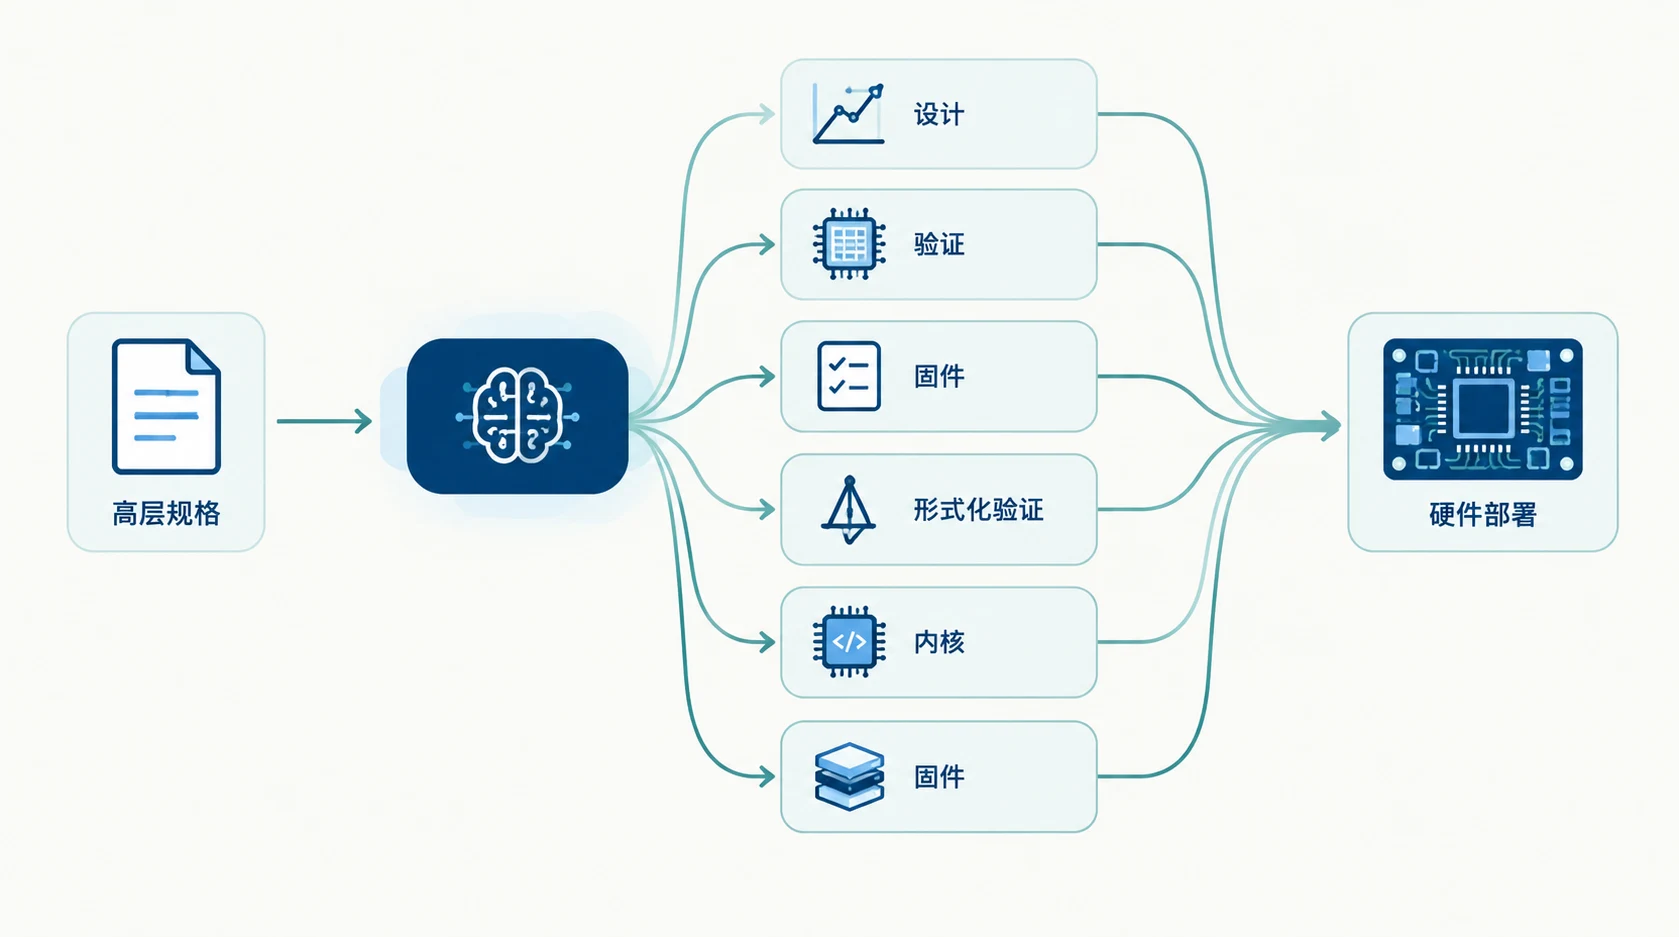
把“AI 设计芯片”拆开看,自动化的具体产出包括六类:性能模型、RTL 设计、UVM 验证环境、形式化证明、固件和内核。
验证环节用了三种手段:商用 EDA 工具、专有形式化引擎,以及硬件在环验证。论文称每个模块达到 95% 覆盖率。这里的 95% 是覆盖率指标,具体统计口径论文摘要层面未展开,不宜直接理解为“设计正确率”或“流片成功率”。
另一项更贴近工程现实的数字是 48 小时:规格变更后,重新验证并重新部署到硬件在这个时间内完成。对硬件团队来说,这条可能比“两周”更有参考价值——它意味着修改成本被压到了接近软件迭代的量级。
3.4 倍能效比,要先看清它的三个前提
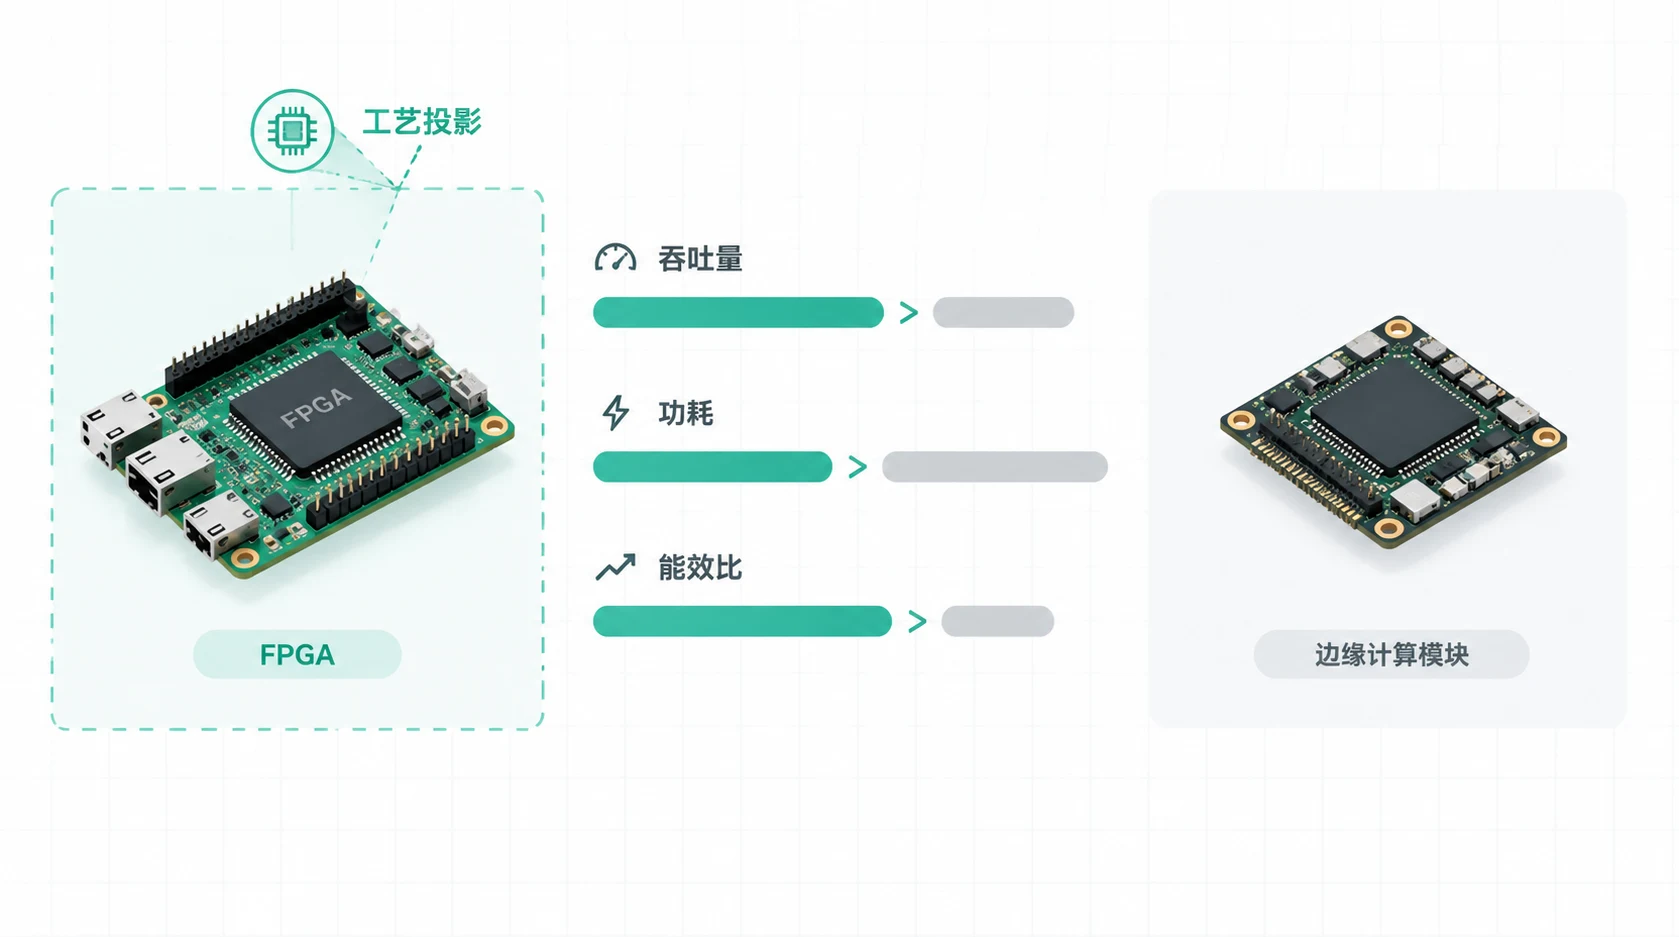
性能对比是这篇论文最容易被误读的部分,需要拆成三层。
第一层:数字本身。 投影到三星 8nm(Jetson Orin Nano 的工艺级别)时,Redwood 在同一批模型上对比实测 Jetson 基线,吞吐量为其 1.75 倍,功耗低 1.9 倍,性能功耗比提升 3.4 倍。
第二层:这不是同工艺实测。 3.4 倍来自工艺投影,基线则是实测的 Jetson。投影与实测混用,意味着这个倍数不能被当作“同条件下 Redwood 比对手强 3.4 倍”来引用。
第三层:产品形态不止一种。 Redwood 面向物理 AI 的单批次、低功耗、超低延迟推理;Redwood Nano 是它的超低功耗 FPGA 变体,可运行 Llama 和 Qwen 等数十亿参数模型。论文未给出该变体的更多细节,因此它的实际部署位置和性能表现目前无法评估。
让 Qwen 参与设计下一代 Redwood,边界在哪里
论文提到一个容易被放大解读的细节:在 Redwood 上运行的 Qwen 也帮助设计了下一代 Redwood,作者称这是“迈向递归自我改进的早期一步”(an early step toward recursive self-improvement)。
“早期一步”这个措辞本身已经划定了边界:它是方向性描述,不是已完成的能力。同样需要限定的还有两处表述——“首个生产级 AI 设计加速器”以“据我们所知”开头,未提供独立验证;“规格说明之下无人类干预”的前提,是高层规格仍由两位人类架构师提供,人类并没有退出链条,只是上移到了规格层。
综合来看,本文认为,判断同类“AI 造芯片”报道时可以固定问三个问题:性能数字是同工艺实测还是投影,基线是怎么选的,人类留在链条的哪一环。这三个问题足以过滤掉大部分夸张叙事。
Redwood 给出的答案并不完美,但它把设计周期这个长期被当作背景条件的变量,变成了可以被压缩的对象。对硬件从业者来说,接下来值得盯的不是两周这个数字能不能再缩短,而是 48 小时的重验证能力能否在更复杂的设计上复现——那才是专用化路线能否持续兑现收益的关键。
来源:查看原文